Domain phsw.de kaufen?
Wir ziehen mit dem Projekt
phsw.de um.
Sind Sie am Kauf der Domain
phsw.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain phsw.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **


Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Nivea Schutz & Pflege Sonnenlotion LSF 30 200mlNIVEA Sun Protect & Moisture Lotion SPF 30 - 200 ml NIVEA Sun Protect & Moisture Lotion SPF 30 is a moisturizing sunscreen that combines effective sun protection with daily skin care. It protects the skin against both UVA and UVB rays and helps prevent sun damage and premature skin aging. The light lotion absorbs quickly and leaves the skin soft, supple and well-groomed without feeling greasy or sticky. At the same time, it provides long-lasting moisture, so the skin maintains its comfort even in sunny conditions. Suitable for daily use on both body and face, when the skin needs reliable protection and simultaneous care in one and the same formula.13,90 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter


-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **

Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Dankbarkeitskerze »Gesundheit«Spüren Sie das Gefühl von tiefer Dankbarkeit und bringen Sie diese achtsam mit wohltuenden Düften zum Ausdruck. Diese hochwertigen Intentionskerzen, die aus 100 Prozent pflanzlichem Stearin (kbA), einem natürlichen Holzdocht und feinsten naturreinen bio-ätherischen Ölen bestehen, werden in liebevoller Handarbeit in Deutschland für Sie gefertigt. Ihre Brenndauer beträgt bis zu 80 Stunden. Die Kerzen werden im hochwertigen Glasbehälter in Kristallglasoptik in einer edlen schwarzen Geschenkverpackung mit goldenem Etikett geliefert. »Gesundheit« Spüren Sie tiefe Dankbarkeit für Ihre bisherige Gesundheit und bringen Sie noch mehr Wohlgefühl in Ihr Leben. Die Duftnoten der Verbene und des Abramelin-Öls erfüllen Sie mit Selbstliebe sowie Entspannung.29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Nivea Schutz & Pflege Sonnenspray LSF30 200mlSonnenschutzspray bietet sofortigen SPF 30 UV-Schutz mit 48-Stunden-Feuchtigkeitspflege in einer wasserresistenten Formel. NIVEA SUN Protect & Moisture Pump Spray hilft, gesunde Haut von innen und außen mit antioxidativem Vitamin E zu schützen und hält die Haut bis zu 48 Stunden mit Feuchtigkeit versorgt. SPF 30 sofortiger UV-Schutz Antioxidative Unterstützung durch Vitamin E Wasserresistente Formel 78% biologisch abbaubare Formel Frei von den UV-Filtern Octinoxate, Oxybenzone und Octocrylene Frei von Mikroplastik Flasche aus 95% recyceltem Material (ohne Kappe, Pumpe) Entwickelt für zuverlässigen Sonnenschutz und langanhaltende Feuchtigkeit, mit einer ozeanschonenden Formel.15,50 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter
-
Nivea Schutz & Pflege Sonnenlotion LSF 30 200mlNIVEA Sun Protect & Moisture Lotion SPF 30 - 200 ml NIVEA Sun Protect & Moisture Lotion SPF 30 is a moisturizing sunscreen that combines effective sun protection with daily skin care. It protects the skin against both UVA and UVB rays and helps prevent sun damage and premature skin aging. The light lotion absorbs quickly and leaves the skin soft, supple and well-groomed without feeling greasy or sticky. At the same time, it provides long-lasting moisture, so the skin maintains its comfort even in sunny conditions. Suitable for daily use on both body and face, when the skin needs reliable protection and simultaneous care in one and the same formula.13,90 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Ähnliche Suchbegriffe für Datenquellen
-
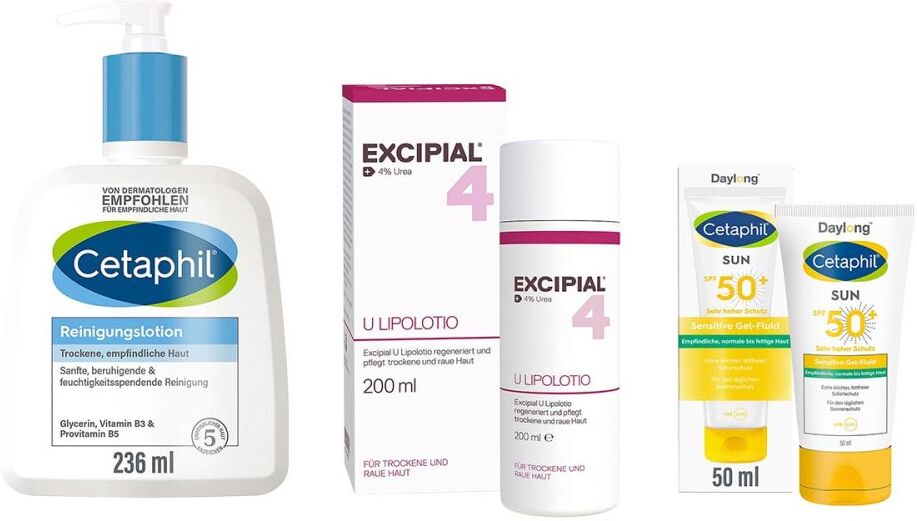
Excipial & Cetaphil Set: Reinigung, Pflege & UV-SchutzAnwendungsgebiet von Excipial & Cetaphil Set: Reinigung, Pflege & UV-Schutz Komplettpflege für sehr trockene & empfindliche Haut: Mit diesem Excipial & Cetaphil Set: Reinigung, Pflege & UV-Schutz wird Ihre Haut sanft gereinigt, intensiv gepflegt & effektiv vor UV-Strahlung geschützt.Reinigen:Cetaphil Reinigungslotion für Körper & GesichtCetaphil Reinigungslotion für Körper & Gesicht ist eine seifenfreie Reinigungslotion zur täglichen Anwendung bei empfindlicher, trockener Haut. Im praktischen Pumpspender. Ohne Duftstoffe.Die seifen- und duftstofffreie Cetaphil Reinigungslotion ist besonders für die tägliche Reinigung empfindlicher und trockener Haut geeignet. Die empfindliche Haut an Körper und Gesicht wird sanft gereinigt und gleichzeitig beruhigt und gepflegt. Die Lotion kann mit und ohne Wasser verwendet werden und ist auch als Make-up Entferner geeignet. Für eine zarte und geschmeidige Haut.Der Schlüssel zu gesunder HautVerwendung mit und ohne Wasser möglichSchonend und gut verträglich, selbst für irritierte HautGeeignet zur Make-up EntfernungFrei von Duftstoffen, nicht komedogenGeeignet für trockene, empfindliche HautIm praktischen PumpspenderEffektiv und sanft zugleich – Die Cetaphil ReinigungslotionEmpfindliche Haut reagiert bei falscher Reinigung häufig mit Irritationen. Reinigungsprodukte entfernen oft nicht nur Schmutzpartikel, sondern beschädigen auch den schützenden Hypolipidfilm der Haut. Bei empfindlicher Haut haben aggressive Reiniger und Peelings daher nichts zu suchen.Die Cetaphil Reinigungslotion ist seifenfrei und befreit die Haut effektiv und sanft von Schmutz und Make-Up. Feuchtigkeitsregulierende Substanzen schützen die Haut vor dem Austrocknen. Die Lotion stärkt zudem die Barrierefunktion der Haut und sorgt für ein weiches, glattes Hautgefühl.Für wen ist Cetaphil Reinigungslotion geeignetDie Cetaphil Reinigungslotion ist besonders für empfindliche und trockene Haut geeignet. Sie kann mit oder ohne Wasser angewe39,99 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Steffek, Frauke: Verbraucherführerschein: Hygiene und GesundheitVerbraucherführerschein: Hygiene und Gesundheit , Vermittlung lebenspraktischer Kompetenzen (6. bis 8. Klasse) , Zündkabel & Zündkabelstecker > Elektrik & Zündungen , Erscheinungsjahr: 201206, Produktform: Geheftet, Beilage: Broschüre klebegebunden, Autoren: Steffek, Frauke, Seitenzahl/Blattzahl: 72, Keyword: 6. bis 8. Klasse; Hygiene & Gesundheit; Lebenspraxis; SoPäd, Fachschema: Hygiene (allgemein) - Sauberkeit~Reinlichkeit~Sauberkeit~Gesundheit (allgemein)~Didaktik~Unterricht / Didaktik, Bildungsmedien Fächer: Gesundheitslehre, Fachkategorie: Unterricht und Didaktik: Religion~Medizin und Gesundheit: Ratgeber, Sachbuch~Didaktische Kompetenz und Lehrmethoden, Bildungszweck: Förderschule/Förderzentrum/Schule mit Förderschwerpunkt Lernen, Altersempfehlung / Lesealter: 23, Genaues Alter: FÖS, Warengruppe: HC/Schulbücher/Unterrichtsmat./Lehrer, Fachkategorie: Unterrichtsmaterialien, Thema: Verstehen, Schulform: FÖS, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Persen Verlag i.d. AAP, Verlag: Persen Verlag i.d. AAP, Verlag: Persen Verlag in der AAP Lehrerwelt GmbH, Länge: 297, Breite: 207, Höhe: 7, Gewicht: 224, Produktform: Geheftet, Genre: Schule und Lernen, Genre: Schule und Lernen, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0010, Tendenz: +1, Schulform: Förderschule, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch, WolkenId: 106093429,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.